

AI 知识来源帮助我们的 AI 功能,如 AI 代理和 AI 助手,使用您的业务内容(常见问题、文档和帮助指南)准确响应本指南说明如何添加、管理和优化知识来源以改善代理表现
支持的文件类型和链接格式
您可以添加结构化和非结构化内容作为知识来源
支持的格式包括:
文件: .pdf, .txt, .md, .csv, .docx, .pptx, .ppsx
图片: .jpeg, .png, .bmp, .webp, .tiff
链接: 公开网页 URL
注意:对于 AI 代理的附件发送,仅支持 .pdf、.docx、.pptx、.jpg、.jpeg 和 .png 格式的 URL。其他文件类型可以作为知识来源添加,但不会作为渲染后的附件发送。
添加知识来源
知识来源是 AI 代理和 AI 助手用来生成有用且与上下文相关的响应的主要数据。这些资料会自动索引,并通常在几分钟内准备好使用。
您可以从以下位置添加或管理知识来源:
AI 代理 > 管理知识来源
AI 代理 > 选择一个 模板 或 从头开始 > 添加知识来源
工作区设置 > AI 助手 > 管理知识来源
在任意一个位置,您可以:
上传文件
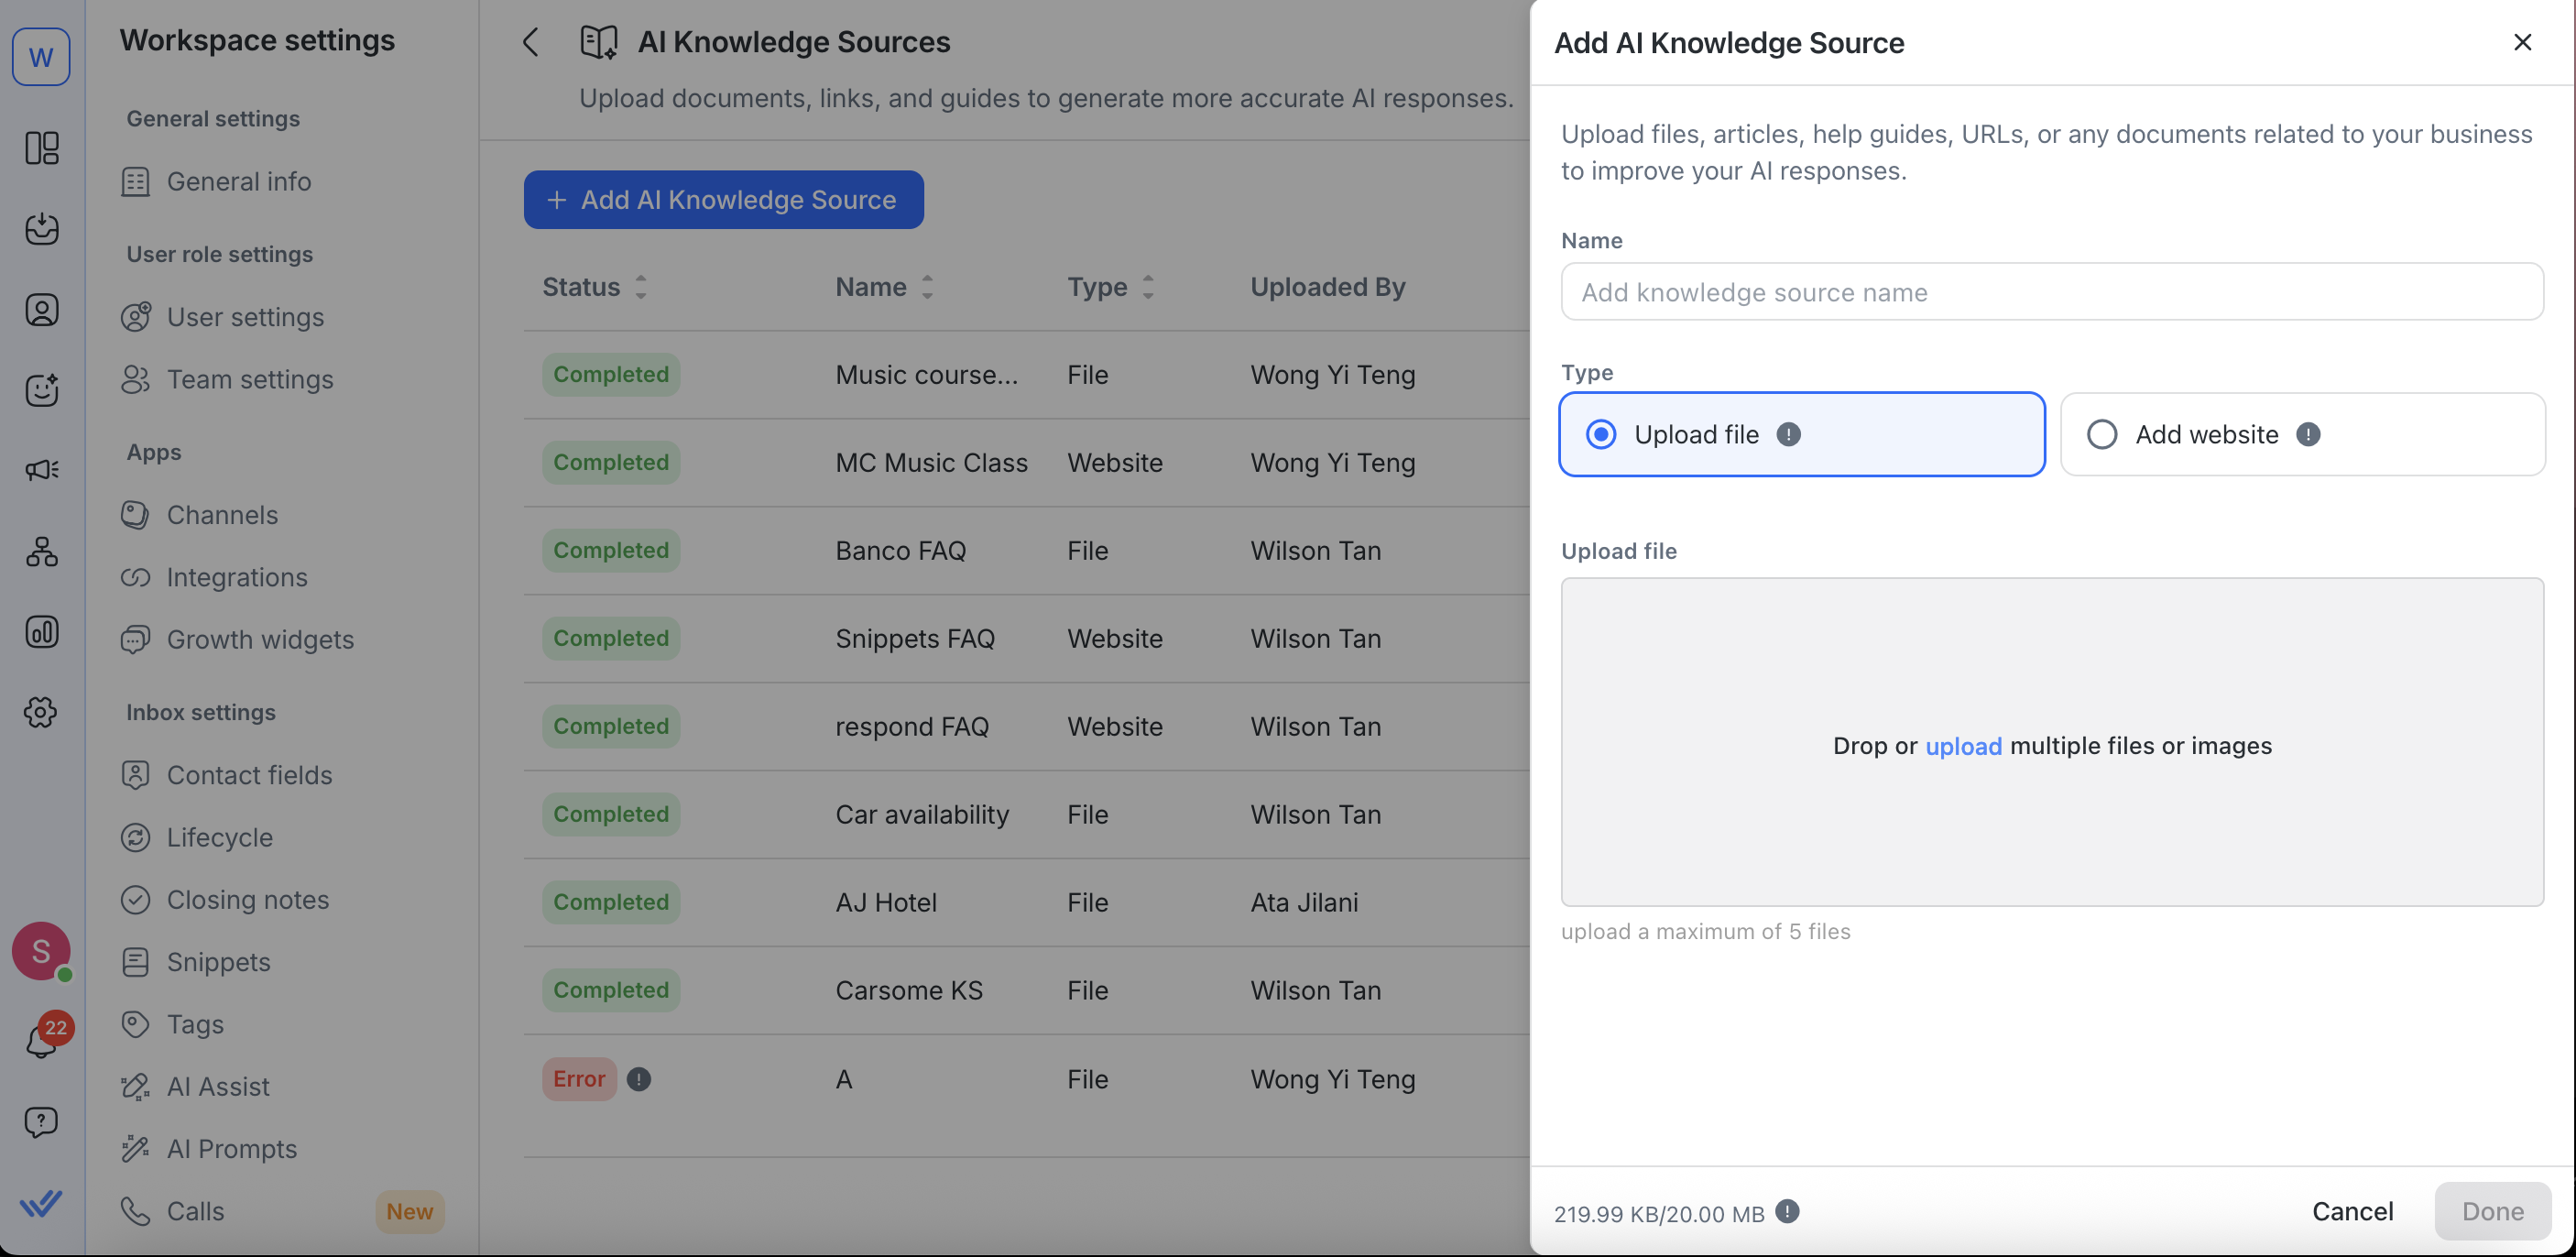
拖放多个支持的文件:.pdf、.txt、.md、.csv、.docx、.pptx、.ppsx,以及图片格式(.jpeg、.png、.bmp、.webp、.tiff)。
您可以每次上传最多 5 个文件,每个工作区最大可有 100 个基于文件的知识来源。
文件大小限制:每个文件 20MB。
重要:试用计划每个文件的大小限制为 1MB,而 付费计划 允许每个文件最高 20MB。
添加网站 URL
在 网站 URL 字段中粘贴任何公共网页 URL。
默认情况下,爬虫会 向下爬取 3 层,但可调整至 100 层。
您可以在一个网站知识来源下添加最多 5 个额外 URL。
点击 重新同步 刷新内容或设置自动同步计划以保持其更新。
您可以并行上传最多 3 个知识来源(文件或网站链接)— 不必等一个完成后再开始另一个。
监控状态
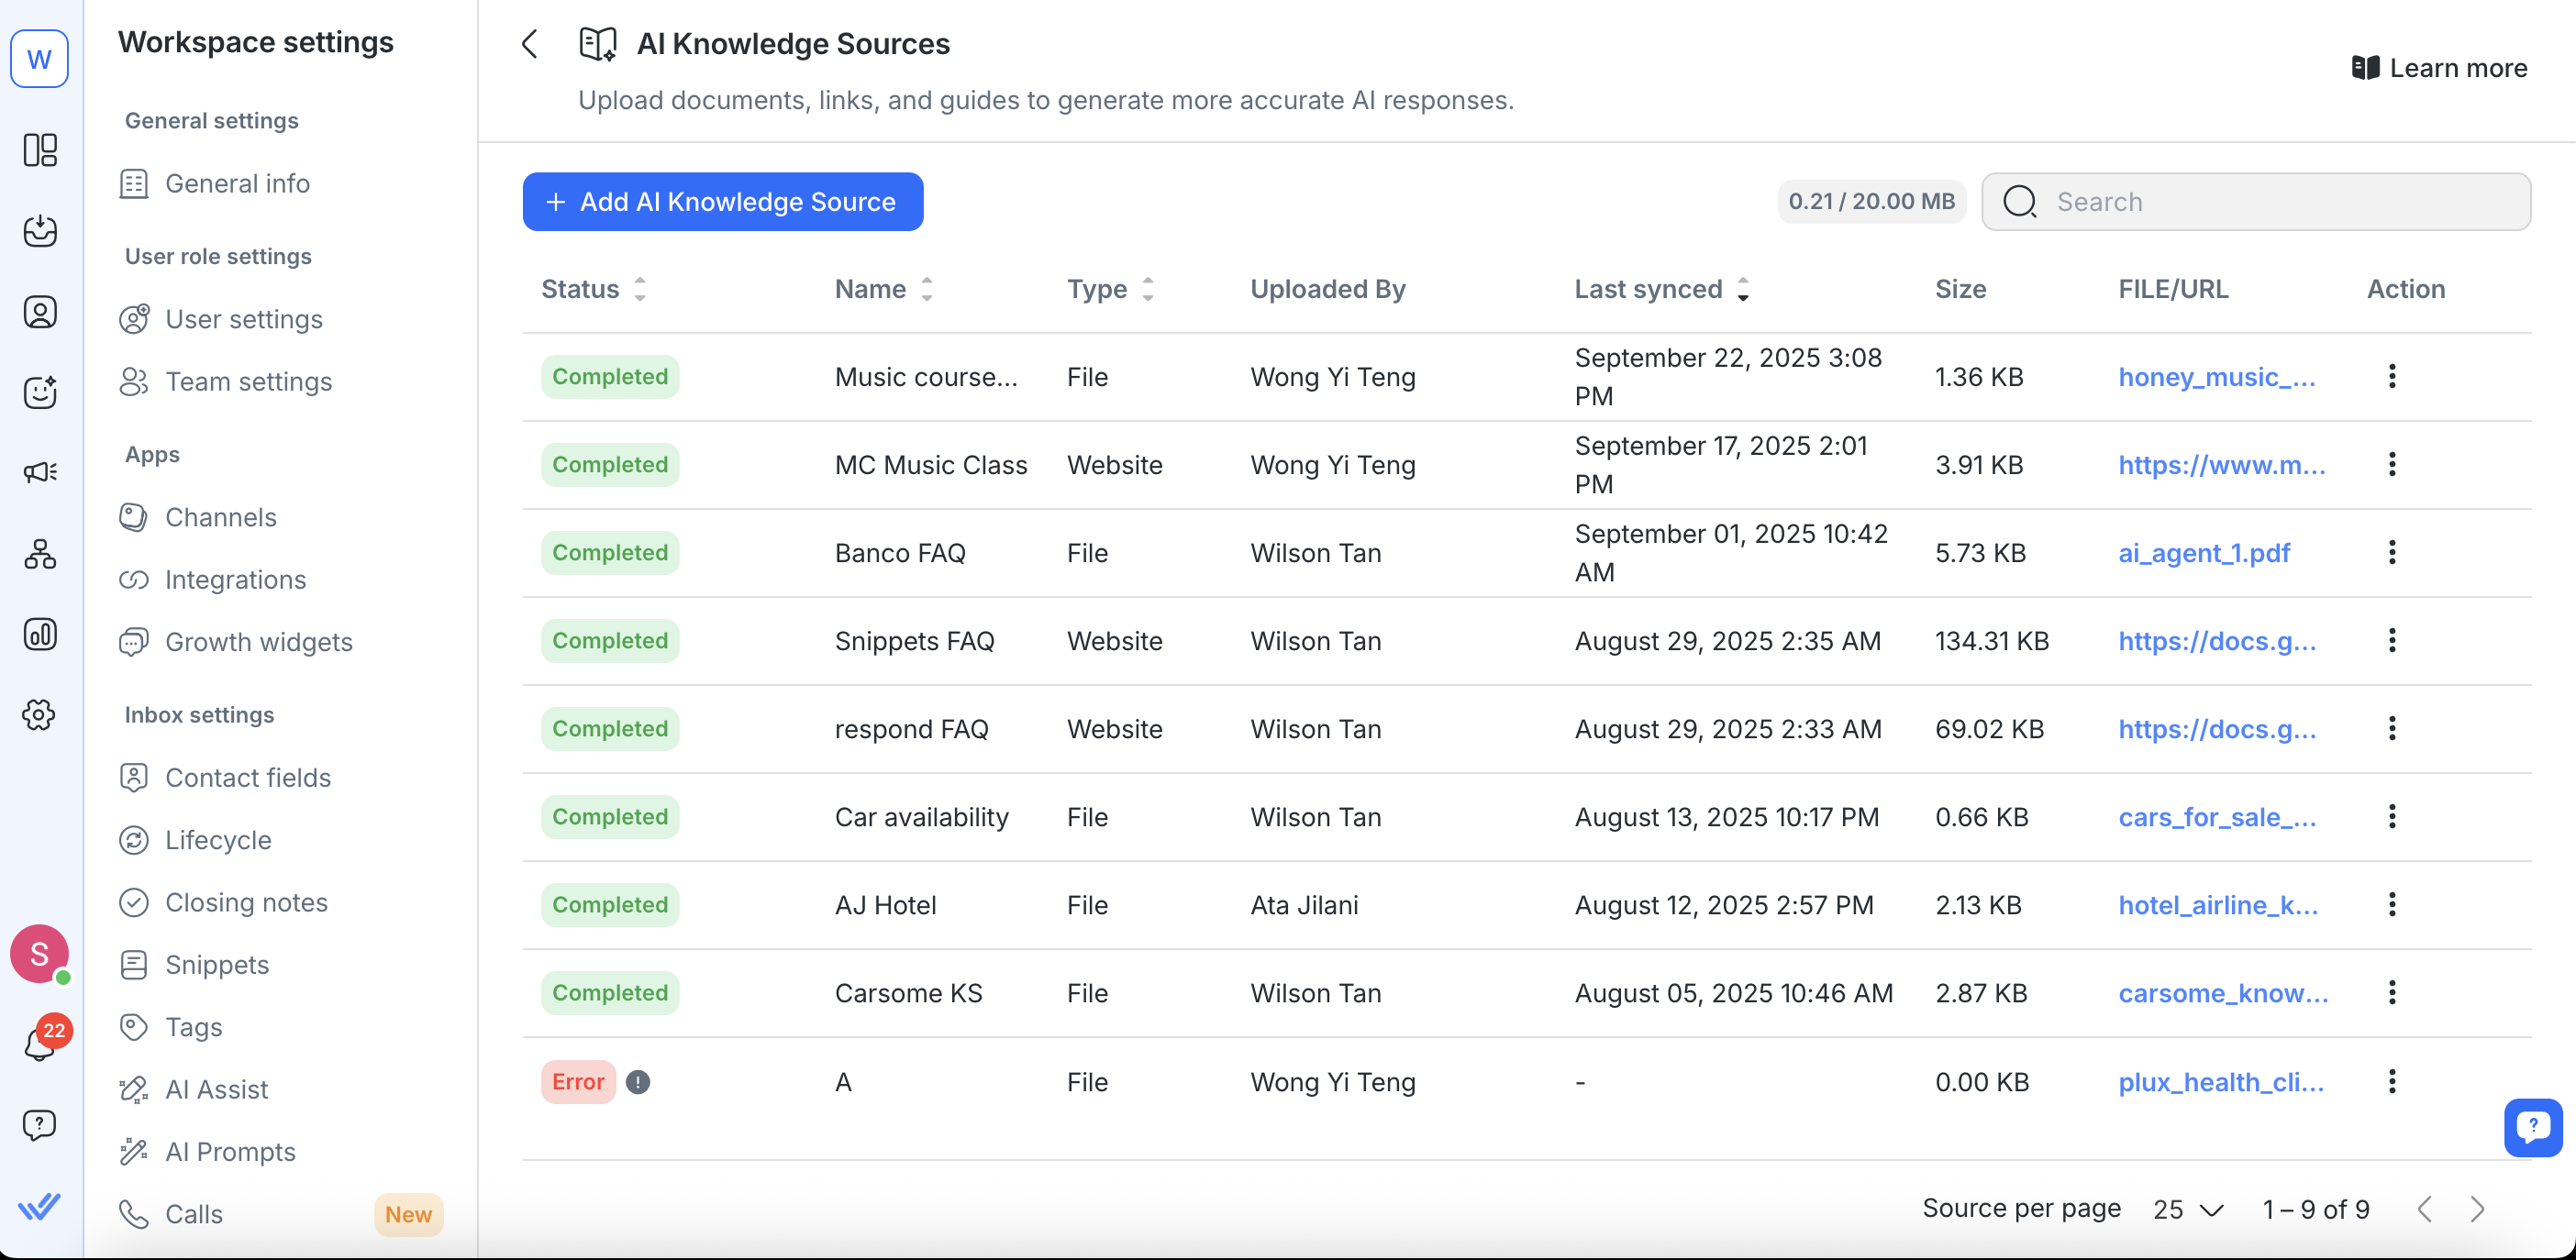
每个知识来源显示一个状态:
已完成 – 准备使用
进行中 – 正在处理或索引
错误 – 需要修复(例如,文件不可读,爬虫被阻止)
部分完成 – 一些内容已保存,但处理达到了限制或超时
了解有关在 AI 助手中使用知识来源的更多信息 在这里。
高级设置(用于网站知识来源)
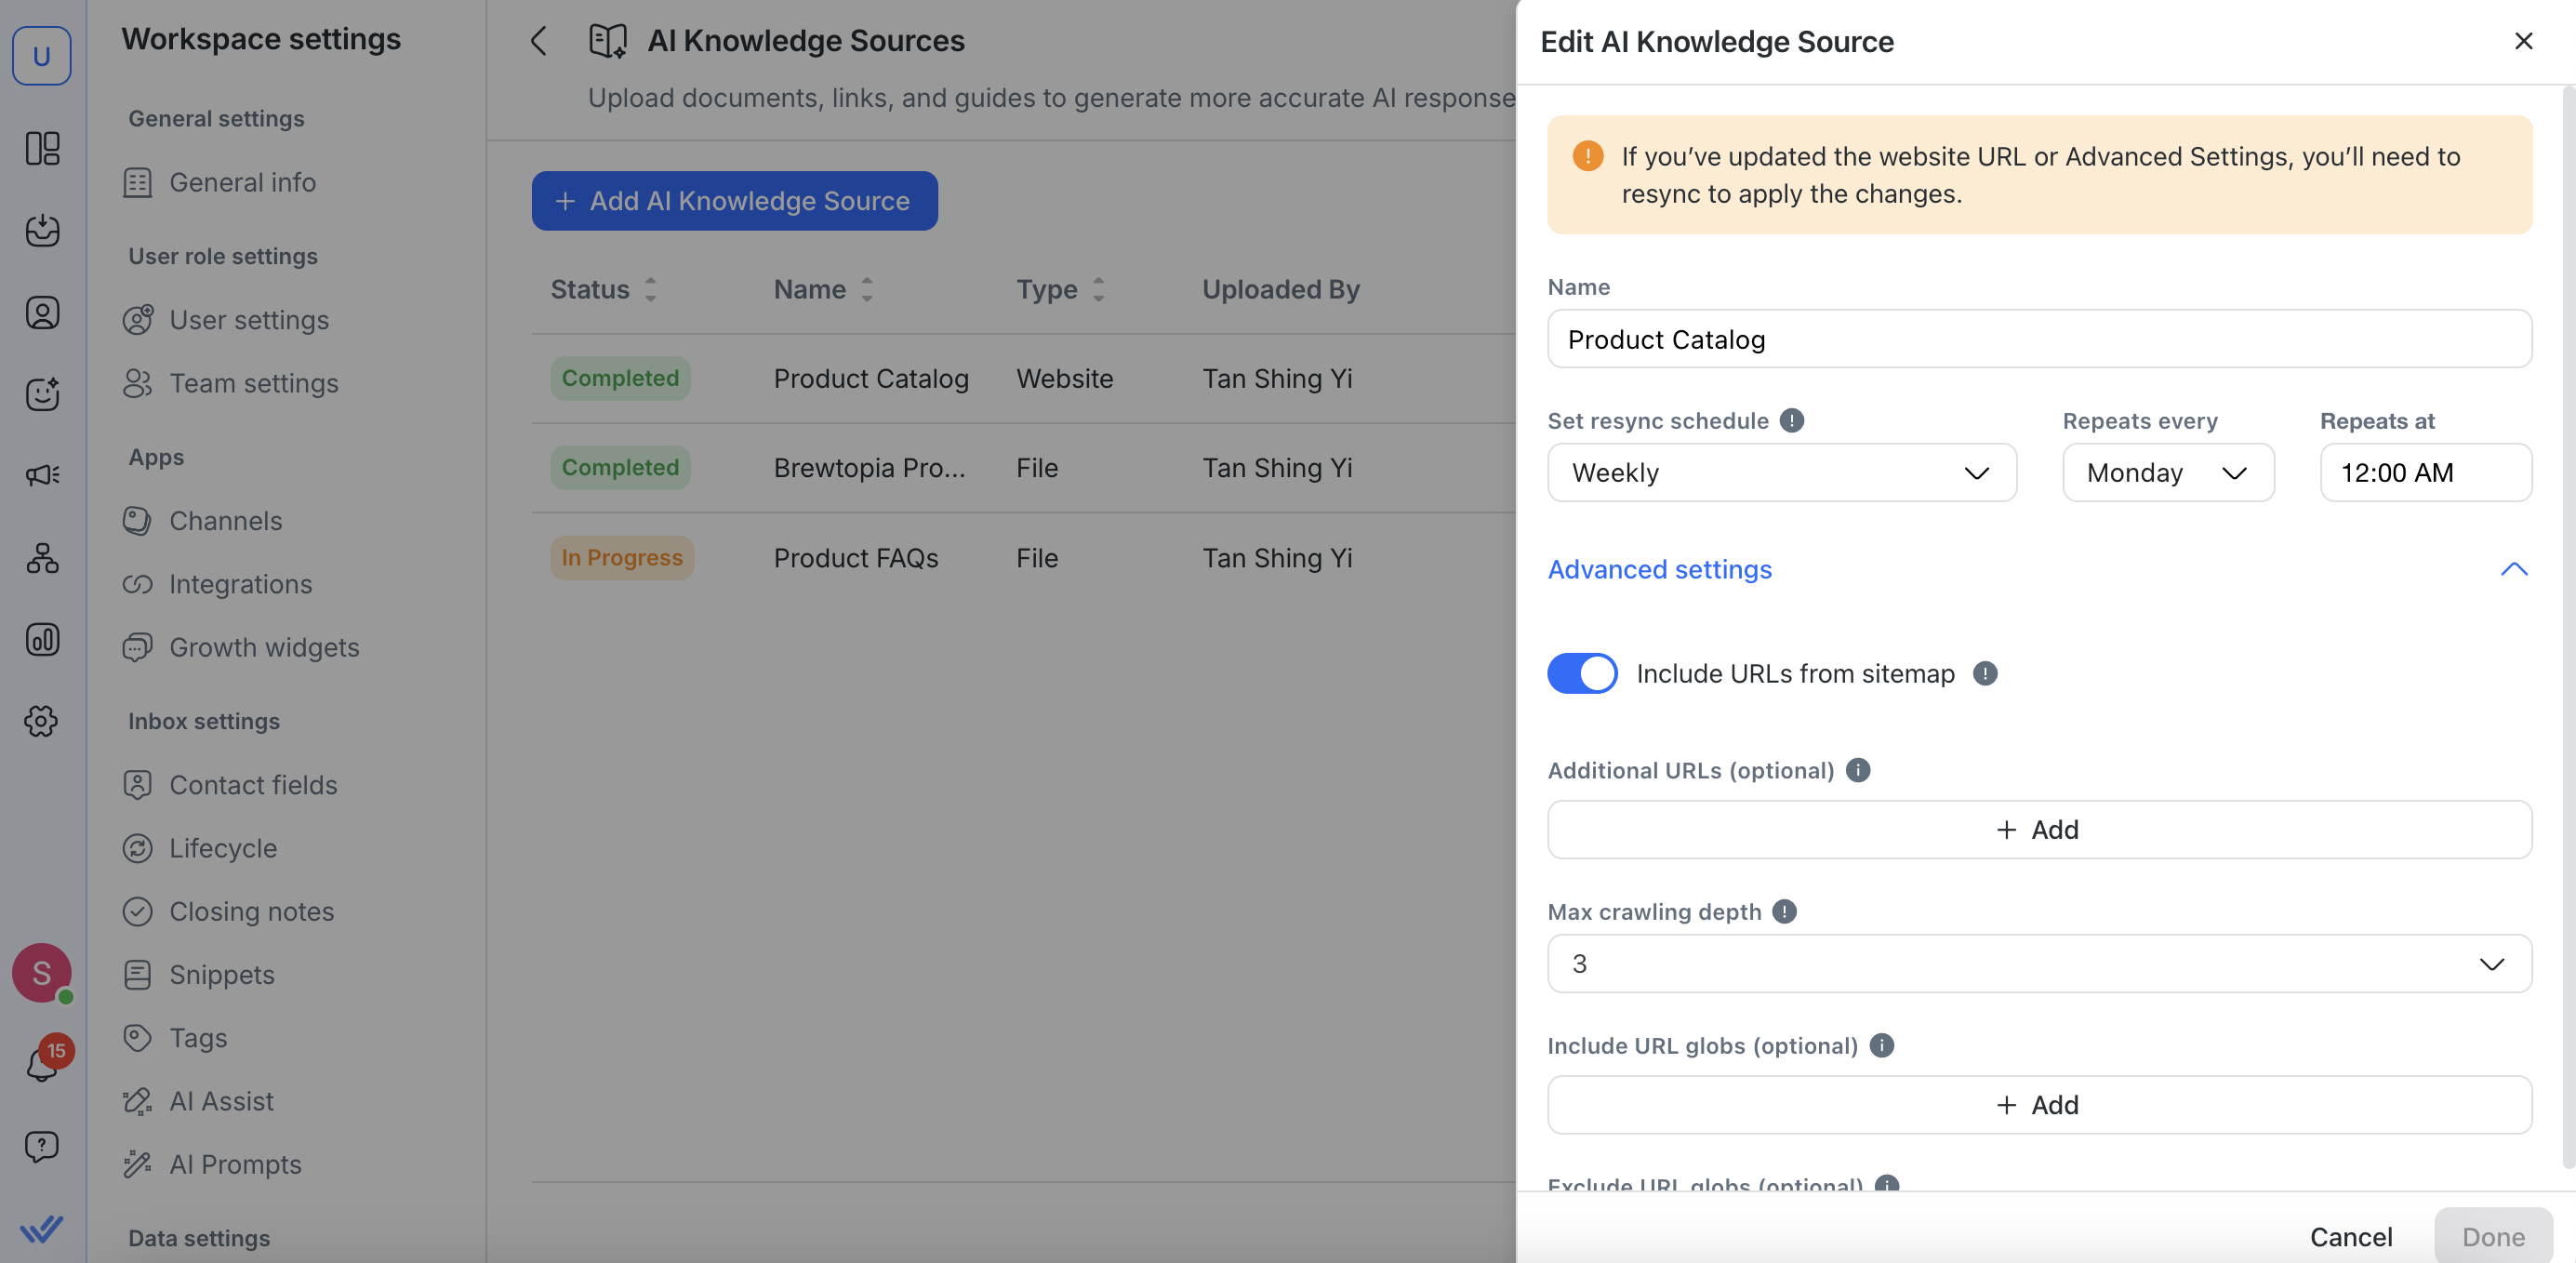
添加或编辑网站知识来源时,您可以在 高级设置 中微调爬虫行为:
包含来自网站地图的 URLs
默认情况下启用。如果您希望爬取更多 URL,包括未从您添加的网站 URL 链接的页面,请使用此选项。
您还可以手动将网站地图作为 URL 添加(例如,https://example.com/sitemap.xml)。
网站地图中的页面从爬取深度 1 开始,较大的网站地图可能需要更长的爬取时间。
额外 URL(可选):最多添加 5 个入口点。
最大爬取深度
设置跟踪多少链接层级。例如,0 意味着只爬取提供的 URL,1 包括直接链接的页面。
较高的值允许更深的爬取。默认情况下爬取深度设置为 3。
包含 URL 全局表达式(可选):
指定您希望爬虫包含的页面的 URL 模式。
这仅适用于在页面上找到的链接—而不是您输入的 网站 URL。要确保特定页面被爬取,请将其 URL 直接添加到 网站 URL 下。
排除 URL 通配符(可选):
使用此选项以排除某些 URL 不被爬取。
这仅适用于在页面上找到的链接—而不是 网站 URL,后者始终会被爬取。
什么是 URL 全局表达式?
glob 是一种模式,您可以用来告诉爬虫哪些页面应包含或跳过,而无需逐一列出每个 URL。
*(单个星号)仅覆盖 一个级别 的页面。**(双星号)覆盖 所有级别,包括更深的子页面。
包含全局表达式
正确示例:
https://example.com/docs/*→ 仅包含直接位于/docs/下的页面(如/docs/page1),而不包括更深的路径。https://example.com/help/**→ 包括/help/下的所有内容,包括子文件夹和嵌套页面(如/help/tutorials/page1)。
不正确示例:
https://example.com/*help*→ 无法按预期工作。单个 * 仅在一个路径段中匹配,而不跨文件夹。example.com/**→ 缺少 https:// 协议,爬虫可能会拒绝。
排除全局表达式
正确示例:
https://example.com/docs/*→ 仅跳过/docs/下的直接页面(如/docs/page1),但不会跳过更深的页面。https://example.com/archive/**→ 跳过/archive/下的所有内容,包括嵌套文件夹和子页面。
其他正确示例:
https://example.com/**?foo=*→ 跳过任何包含查询参数foo的example.comURL。
不正确示例:
/*?foo=*→ 太广泛;可能会意外跳过所有域中的页面。始终包含您的域(例如,https://example.com/**?foo=*)。https://example.com/(没有/**) → 仅排除主页,而不排除子页面。
为什么使用全局表达式?
当您的网站包含对 AI 训练既有用又无用的页面混合时,通配符尤其有用。它们让您能够更好地控制:
节省时间:而不是逐一添加数十个相似的 URL,可以使用单一模式将它们全部包含。
减少噪声:排除不相关的部分(例如,营销页面、博客档案或登录页面),以便 AI 仅专注于与支持相关的内容。
处理复杂网站:对于大型帮助中心或多域设置,通配符可确保覆盖相关部分,而不会过度同步无关内容。
防止错误:通过排除问题或不相关的 URL(如暂存环境或过时的档案),您可以减少爬取失败,并提高 AI 响应质量。
撰写有效全局表达式的技巧
要具体但不要过于狭窄:
https://example.com/help/**比https://example.com/**要好,后者可能会爬取过多无关内容。使用排除全局表达式进行清理:如果您的支持页面包含混合内容,请使用排除模式(例如,
*/promo/**)来过滤营销材料。避免重叠全局表达式:重叠的包含和排除规则可能会导致混淆。始终仔细检查模式,确保不会意外跳过重要页面。
AI 代理如何使用知识来源
在设置 AI 代理时——无论您是从模板开始还是从头构建——您可以立即连接相关的知识来源。您还可以稍后通过转到 AI 代理 > 管理知识来源 来管理它们。

知识来源用于:
准确回答产品问题
提供上下文中的帮助内容
避免 AI 代理在响应时产生幻觉或猜测
在创建或编辑 AI 代理时,你会在“说明”下方看到 知识来源 部分:
最多显示 4 个已启用的知识来源,其余显示在 显示更多。
单击 管理(至少启用一个知识来源后会显示)以 添加新的知识来源、从库中选择 或 转到库。

从您的库中选择
从库中选择会打开一个面板,你可以在其中执行以下操作:
搜索整个工作区的所有知识来源
选择单个来源,并有计数器显示已选择的数量
查看每个来源的名称、图标(文件或网站)和状态
单击 管理 转到知识来源模块,或单击 保存 确认你的选择。
启用后,AI 代理将使用这些来源来为对联系人的回复提供信息。

知识来源同步状态
为特定 AI 代理选择知识来源时,您可能还会看到以下状态:
失败 – 无法处理。请从知识来源中删除并重新上传它。
部分处理 – 达到工作区文件大小限制,因此只有该知识来源的一部分被处理。移除一些知识来源,然后重试。
重新同步失败 – 上次重新同步未完成,因此内容可能不完整或已过时。您的 AI 代理仍然可以使用它,但请从知识来源重新同步以更新它。
进行中 – 仍在处理。
为了提高准确性和响应质量:
使用主题特定的来源:避免将多个主题合并到一个文件中。
限制噪声:在上传前,删除品牌页脚、免责声明或无关信息。
在测试 AI 代理时,回复可能会显示一个 "{#} 个来源" 标签。这可让您核实用于生成回复的知识来源。单击该标签以查看来源,或选择 管理 来直接更新、重新同步或替换知识来源。
提示:要让您的 AI 代理将图片、小册子或文档作为附件发送,请将文件的 URL 粘贴到您的知识来源或说明中 — 不要上传文件本身。了解更多关于 将文件和图片作为附件发送 的信息。
管理现有知识来源
您可以通过 AI 知识来源 页面更新、替换、重新同步或删除知识来源。
限制:
AI 代理无法对知识来源进行优先排序或选择。它们无法判断哪个文档是“最佳”或最相关的来源。为确保回复准确,您必须明确告诉 AI 代理在知识来源中应搜索的关键字,以引导它。
AI 代理不能按文档标题搜索,只能按内容中的关键字搜索。通过名称引用文档(例如,“查看定价指南”)将无效。相反,请指示 AI 代理在文档中搜索特定术语或概念(例如,“搜索关键字 ‘定价选项’”)。
编辑知识来源
对于编辑文件,您可以:
重命名您的知识来源
替换上传的文件(例如,用 .txt 版本替换 PDF)
对于编辑网站 URL,您可以:
重命名您的知识来源
更新您的网站 URL
设置或调整重新同步计划
在高级设置中进行进一步配置
如果您更新网站 URL 或在高级设置中进行更改,您需要再次同步知识来源,以使更改生效。
删除知识来源
移除未使用或过时的文件或 URL,以保持在限制范围内,并确保您的 AI 功能使用最新的准确信息。
点击 操作 > 删除
已删除的知识来源将不再用于生成回复
查看日志(用于网页 URL)
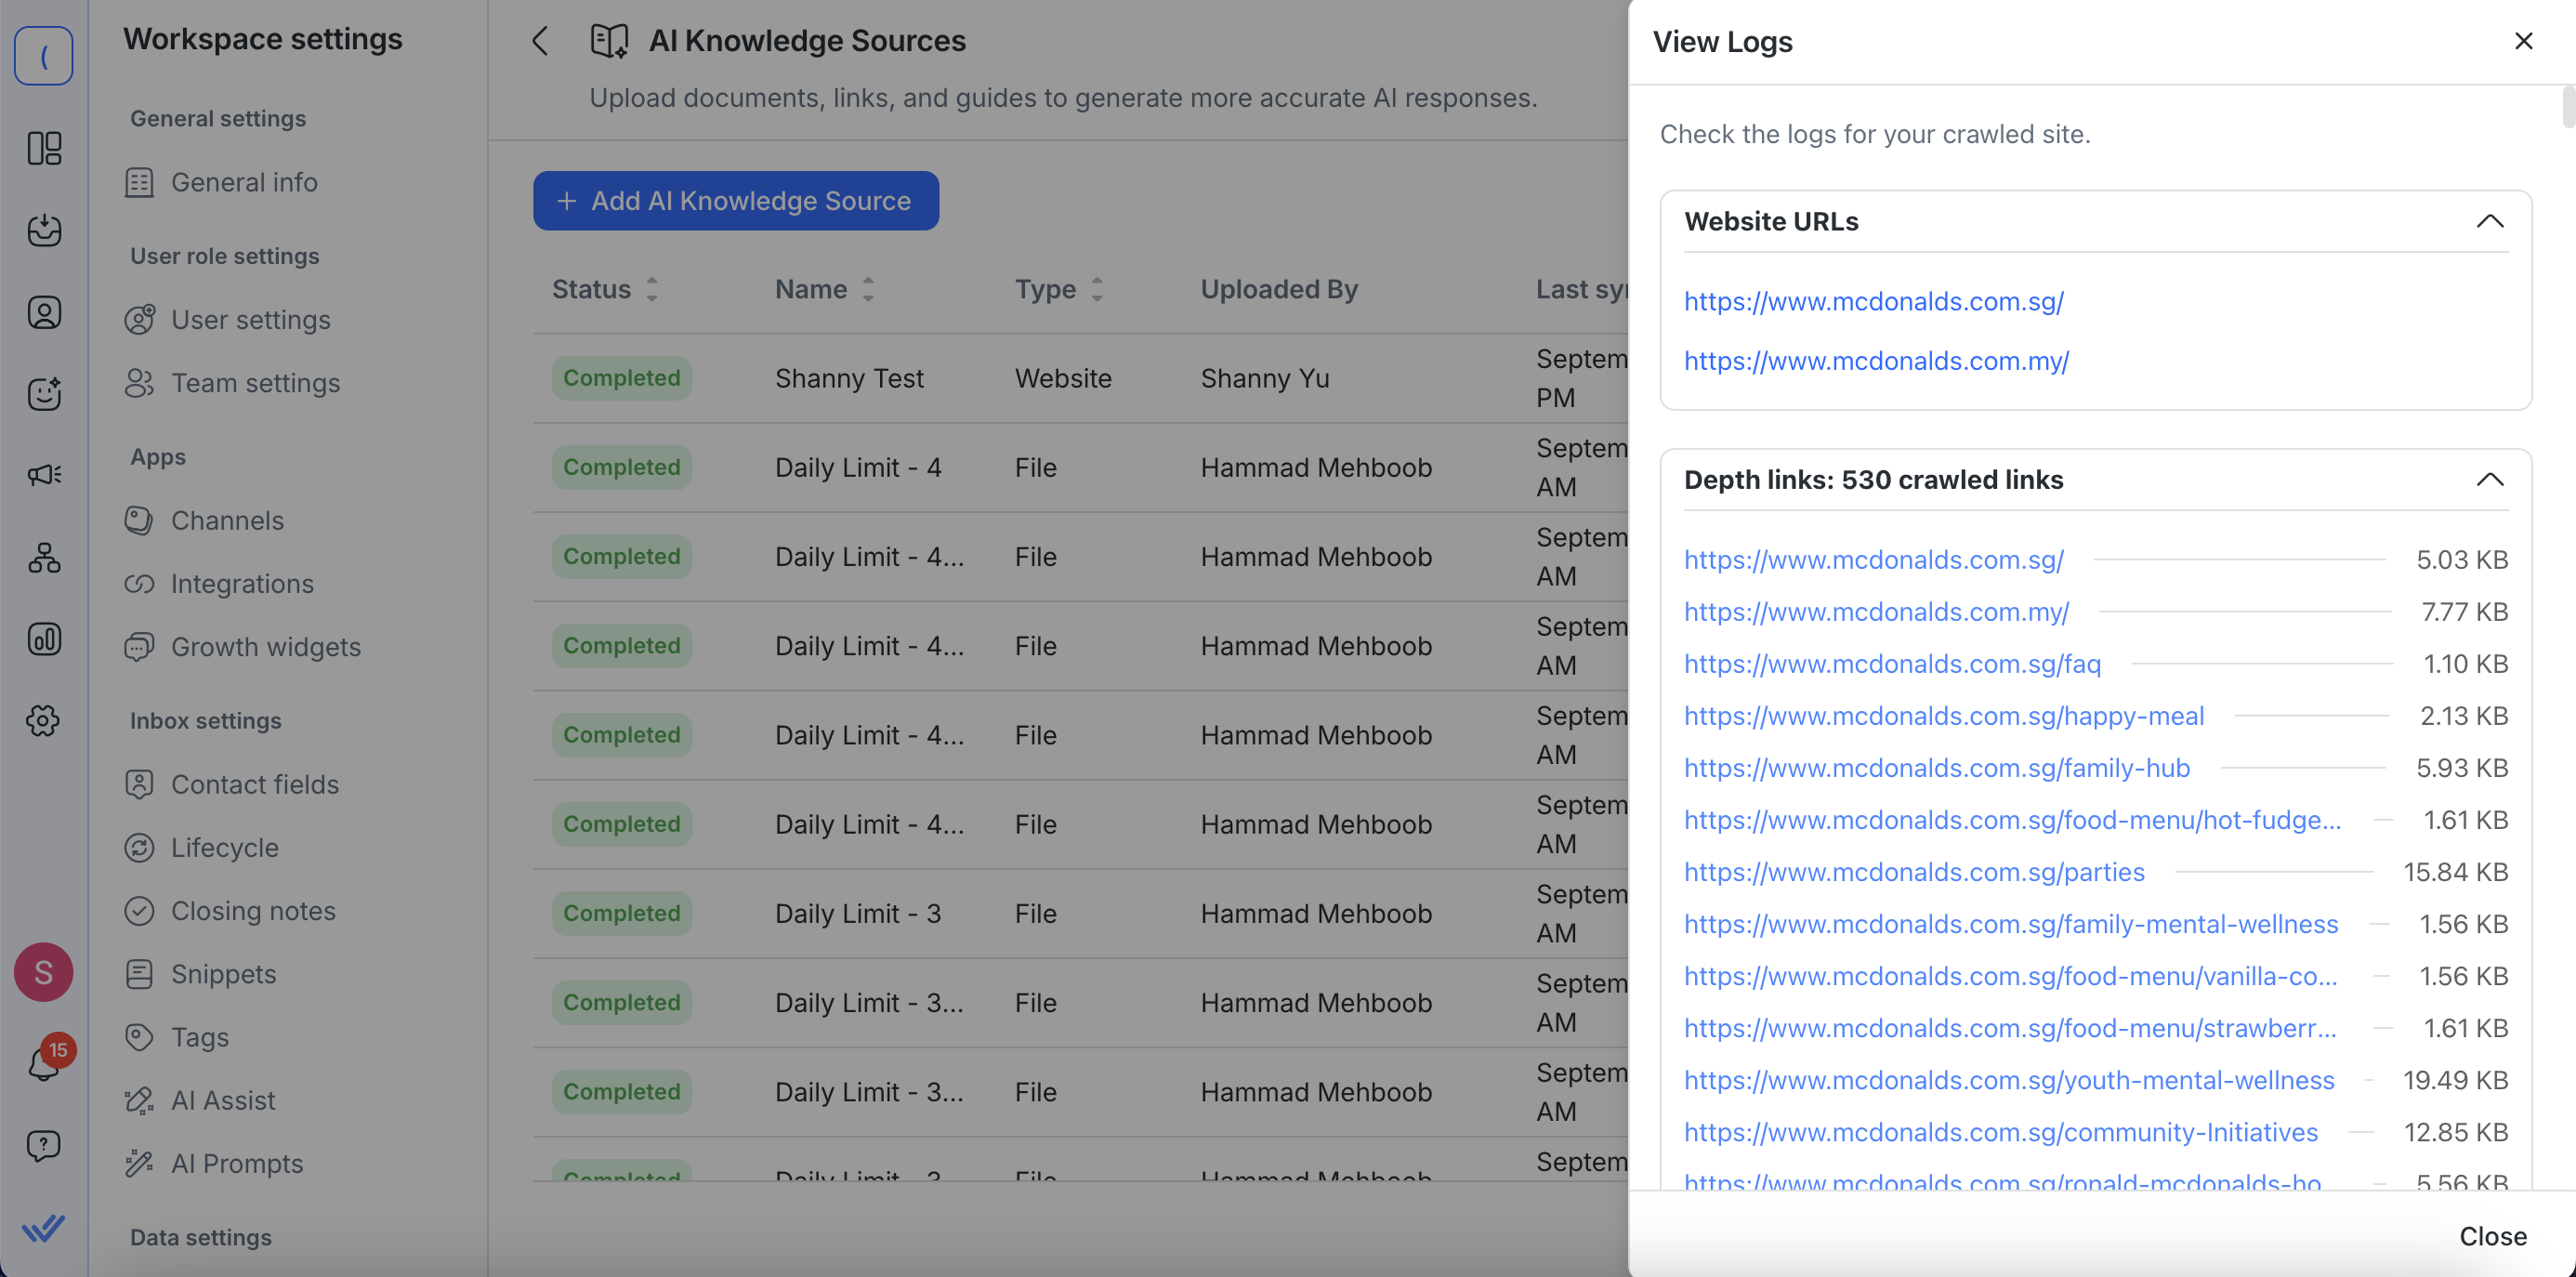
点击 操作 > 查看日志,审核网站知识来源爬取的细节。日志让您完全了解捕获了什么:
起始和其他 URL — 查看您输入的网站 URL 以及在高级设置中添加的任何额外 URL。
所有爬取链接的列表 — 显示每个访问的 URL。
可点击链接 — 每个爬取的链接在新标签页中打开,以便您直接查看爬取的内容。
提取内容大小 — 检查从每页提取的文本量,以 KB 或 MB 为单位显示。
这使得确认重要页面被包含、识别缺失或无关内容以及排查任何爬取问题变得更容易。
重新同步网站来源
刷新过时的网页内容:
点击 操作 > 重新同步 在网站来源旁边
当您点击 重新同步 时,过程会立即开始,并且会显示一个图标以表示正在进行中。

如果重新同步未完全完成,将会收到通知,例如:
达到字符限制:源将显示为 部分完成,并保存截至限制的所有内容
超时或连接错误:抓取可能会提前停止(最长1 小时),并在可能的情况下保留部分内容。
当知识源正在同步时,重新同步会被禁用。
AI 知识源的工作区限制
为了保持顺畅运行,对可以添加多少知识源以及可以存储多少内容有一定的限制。以下是简单的分类:
总存储大小: 每个工作区最多 20MB
文件数量: 每个工作区最多 100 个基于文件的知识源
添加/编辑操作: 每天最多 50 次更改(添加或编辑源)
爬行深度: 网站爬行默认 深入 3 层,但可以将其增加到 100 层
额外网站 URL: 每个知识源可以添加最多 5 个附加 URL
如果达到这些限制,同步和添加新源将暂停,直到释放空间或限制重置。
Google Sheets 限制
Google Sheets 作为网站知识来源 不受支持。添加 Google Sheets URL 可能导致 AI 响应不准确或不可靠。
您可以这样做
将 Google Sheet 下载为 .csv 文件。
常见问题与故障排除
为什么我的知识源状态仍显示“进行中”?
大型网站或深层链接结构需要更长时间进行爬行。如果几个小时未变,请检查 URL 可访问性(robots.txt、登录墙)或减少爬行深度。
对于文件上传,文件过大或损坏的文档也可能导致延迟。如果文件处理困难,请尝试以纯文本或其他支持的格式重新上传一个更清晰的版本以加快索引速度。
为什么我的知识源状态显示“错误”?
错误通常是由于文件损坏、不支持的格式、被阻止的网站或服务器超时引起的。要解决此问题,请尝试以支持的格式重新上传内容(例如 .pdf、.docx、.csv),检查网站的可访问性,或重试爬取过程。
我可以上传私有或内部链接吗?
不,只支持公共 URL。对于私有内容,请将其导出为支持的文件类型(例如,PDF,TXT)并上传该文件。
AI 代理会自动使用所有知识源吗?
当您创建或编辑 AI 代理时,工作区中的所有知识源都会列出。您选择要启用哪些,只有这些选中的知识源才会用于生成对联系人的回复。
我可以将片段用作 AI 代理的知识源吗?
不,目前不支持将片段用作 AI 代理的知识源。如果您希望在未来看到此功能,可以在 这里 投票。
我应该多长时间重新同步一次网站源?
按照计划频繁同步更新的网站(例如,每周或每月)。对于静态内容,手动重新同步就足够了。
我该如何避免过时或不相关的答案?
替换或删除过时的源,使用 glob 排除存档页面,并安排定期重新同步频繁更新的内容。
在抓取知识源时,为什么会看到「Too Many Requests」错误?
当某个知识源在一天内被抓取并删除超过50次时,就会触发速率限制。等待 24 小时,然后再次尝试抓取该知识源。
为避免触发速率限制,请不要在短时间内反复添加、删除或重新添加同一知识源。


